CPU の命令をいかに「遅く」実行できるかを競う Assembly Hall of Shame というプロジェクトがあります。
例えば x86 の fxrstor64 は、条件によっては 1 回の実行に 1 分以上かけられるそうです。
リーダーボードを眺めていると、整数除算命令 idiv を遅くする方法として、除数に対して被除数を大きくすることが挙げられていました。
これを見て、除算命令のレイテンシが入力値によってどのくらい変わるものなのか気になりました。
というわけで本稿では、整数除算命令 idiv について、入力値の大きさを変えたときのレイテンシの変化を調べてみます1。
レイテンシの定義
idiv は符号付き整数の除算命令です。
64 ビットモードの場合、128 ビットの符号付き被除数を RDX:RAX に入れ、64 ビットの除数をオペランドとして渡します。
除算実行後、商は RAX、余りは RDX に入ります2。

符号付き整数除算命令 idiv
Zen 2 における各命令の典型的なレイテンシは Software Optimization Guide for AMD EPYC 7002 Processors に記載されています。
64 ビットのオペランドに対する idiv のレイテンシは 41 サイクルと記載されていますが、オペランドの値とレイテンシの関係には触れられていません。
そもそも整数除算命令は商と余りをそれぞれ異なるレジスタに出力し、両者が後続命令から利用可能になるタイミングが同じとは限らないため、レイテンシの定義は 1 つではありません3が、そのあたりの詳細についても書かれていません。
本稿では、整数除算命令のレイテンシを、被除数の下位 64 ビット(RAX)が利用可能になってから、商と余り(RAX と RDX)の両方を後続命令が利用できるようになるまでの時間と定義します。
ベンチマークの設計方針
入力値の大きさを変えて idiv のレイテンシを計測する 2 種類のベンチマークを用意します。
ベンチマーク 1: 被除数と商のビット数を変える
1 つ目のベンチマークでは、除数を 1 に固定し、被除数を 2 のべき乗で変化させます。 すなわち、被除数のビット数を とおき、
とします。 除数を固定しているので、被除数とともに商の大きさも変化します。
ベンチマーク 2: 被除数を固定して商のビット数を変える
2 つ目のベンチマークでは、被除数を に固定し、商を 2 のべき乗で変化させます。 すなわち、商のビット数を とおき、
とします。 は 64 ビット符号付き整数で表せる最大の 2 のべき乗です。
レイテンシの計測
idiv の入力値を固定した依存チェーンを作る
ある命令のレイテンシを計測したければ、その命令のみからなる依存命令列(依存チェーン)を作り、実行にかかったサイクル数を命令数で割ればよいです4。
この方法で特定の入力値に対する idiv のレイテンシを計測するには、同じ被除数・除数の idiv のみからなる依存チェーンを作る必要があります。
しかし、出力の商を次の命令の被除数に設定すると、除数が 1 の場合を除いて、idiv の入力値が毎回変わってしまいます。
そこで、入力レジスタの値を復元する補助依存チェーンを用意します。
今回は、実験環境における and と or のレイテンシが 1 サイクルであることが既知であると仮定5し、and と or のみからなる補助依存チェーンを追加します6。
まず idiv の直後に RAX と RDX に依存する and 命令を置き、商と余りの両方が利用可能になるのを待ちます。
|
|
そして、ビット演算に関する次の恒等式に基づいて、RAX の値を元の被除数 dividend に戻します。
|
|
これにより、idiv の被除数と除数が常に一定であるような依存チェーンを作ることができます。
除算器の占有時間を考慮する
除算器は、実行が完了してすぐに次の除算を開始できるとは限りません。 次の除算の入力が準備できていても、除算器がビジーな間は、実行を開始できないためです。
AMD Ryzen 7 4700U (Zen 2) には、除算器のビジーサイクル数を数えるパフォーマンスイベント DIV_CYCLES_BUSY_COUNT が用意されています。
|
|
idiv のレイテンシを 、補助依存チェーンのレイテンシを 、1 回の除算で除算器がビジーになる時間(除算器の占有時間)を とすると、
の場合、除算器の占有時間 によって idiv のレイテンシ が隠蔽されてしまいます。
したがって、idiv のレイテンシ を計測するには、補助依存チェーンの長さ を十分大きくする必要があります。
ここまでに追加した 2 個の and と 1 個の or で、補助依存チェーンの長さは 3 サイクルになりますが、除算器の占有時間 は事前には分からないため、さらに 13 個の or rax, rax を追加しておきます。
|
|
これにより、補助依存チェーンの長さ は 16 となり、idiv のレイテンシは、依存チェーンの実行にかかるサイクル数から 16 を引くことで求まります。
なお、ループ先頭の xor edx, edx は RAX に依存せず、並行して実行できるため、補助依存チェーンには含めていません。
ビルドと実行
リポジトリのルートで Zen 2 向けにビルドし、整数除算ベンチマークを実行します。 使用した GCC のバージョンは 16.1.1 です。
|
|
また、auxiliary_dependency_chain.cpp で補助依存チェーンのレイテンシを計測し、期待通り 16 サイクルであることを確認しました。
|
|
計測結果
AMD Ryzen 7 4700U (Zen 2) での計測結果を次の図に示します7。
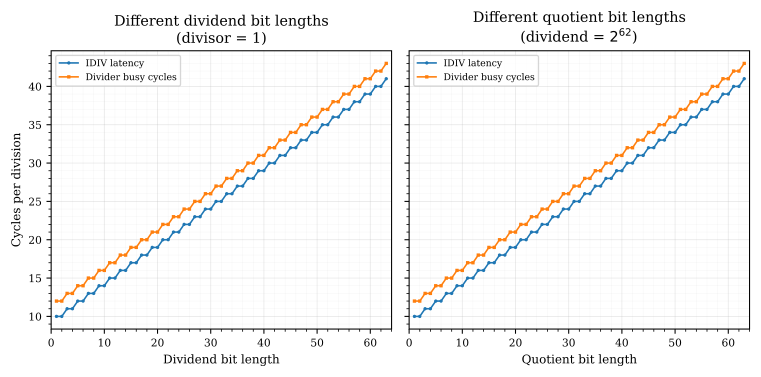
AMD Ryzen 7 4700U における idiv のレイテンシと除算器のビジーサイクル。左図は除数を 1 に固定し、被除数と商のビット数を同時に変えた結果。右図は被除数を に固定し、商のビット数を変えた結果。
左図は 1 つ目のベンチマークの結果で、被除数と商のビット数が 2 増えるごとにレイテンシが 1 サイクルずつ増加しています。 右図は 2 つ目のベンチマークの結果です。 被除数を固定していますが、商のビット数に対して同様の傾向が現れました。
以上の結果から、商のビット数が 2 増えるごとに idiv のレイテンシが 1 サイクルずつ増加することがわかります。
これは、Zen 2 の整数除算器が 1 サイクルに結果を 2 ビットずつ計算する radix-4 方式で実装されているという AMD のドキュメントの記述8とも整合します。
今回計測した範囲では、商のビット数を とすると、idiv のレイテンシ は次式で表せます。
商のビット数が 2 以下ならばレイテンシは 10 サイクル、63 ビットの場合は 41 サイクルとなります。
一方、除算器の占有時間 は、入力値の大きさによらず idiv のレイテンシより約 2 サイクル長くなりました。
したがって、商と余りが利用可能になってから除算器が次の除算を開始できる状態になるまでに、約 2 サイクルかかると考えられます。
参考
- Assembly Hall of Shame
- micro-benchmark-suite
- perf-counter
- Software Optimization Guide for AMD EPYC 7002 Processors
- uops.info — IDIV (R64)
-
Intel 64 and IA-32 Architectures Software Developer’s Manual, Volume 2A ↩︎
-
入力から出力への依存経路によってレイテンシは変わる可能性があります。 ↩︎
-
実際に計測して確認します。 ↩︎
-
結果のプロットには analyze_integer_division.py を使用しました。 ↩︎
-
“The radix-4 hardware integer divider unit can compute 2 bits of results per cycle.” ↩︎