メモリ律速なプログラムを高速化するには、キャッシュ上のデータを再利用し、遅い主記憶(DRAM)へのアクセスを減らすことが重要です。

本稿では、キャッシュのレイテンシを実測する方法を解説します。 キャッシュに関する情報は CPU の仕様書にも記載されていますが、どうすれば仕様書通りの性能を出せるか知っておくことは有益ですし、未知のプロセッサが出てきた場合にも計測できると便利ですからね。

メモリ階層

DRAM 上のデータは、キャッシュライン単位1でキャッシュに読み込まれます。 読み込まれたデータはしばらくの間キャッシュに置かれているため、同じキャッシュライン上のデータに複数回アクセスする場合は、高速に取得できます。

現代の CPU の多くは、速度と容量の異なる複数のキャッシュを持っています。 一般に、容量の大きいキャッシュほどアクセスにかかる時間(レイテンシ)も大きくなります。

レジスタ、キャッシュ、DRAM の速度と容量の関係

レジスタ、キャッシュ、DRAM の速度と容量の関係

CPU はメモリ上のデータにアクセスする際、まず L1 キャッシュに目的のデータが存在するかを確認します。 存在する場合(キャッシュヒット時)はそれを参照し、存在しない場合(キャッシュミス時)は、L2/L3 キャッシュ、DRAM からデータを取得します。

キャッシュ構成の例

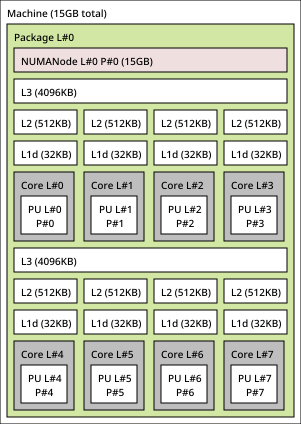
例として、AMD Ryzen 7 4700U (Zen 2) のキャッシュ構成を lstopo コマンドで確認してみます。

1
$ lstopo --no-io --no-icaches --no-legend
AMD Ryzen 7 4700U のキャッシュ構成

AMD Ryzen 7 4700U のキャッシュ構成

  • CPU コアは 8 個
  • L1 キャッシュと L2 キャッシュはコアごとに独立しており、容量は 32 KiB と 512 KiB
  • L3 キャッシュはコア 0〜3 とコア 4〜7 でそれぞれ共有されており、容量は 4 MiB × 2

各階層のキャッシュラインサイズや way 数は次のコマンドで取得できます。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
$ lstopo-no-graphics --no-io --no-icaches -v | grep -Ev "^Machine|depth [0-9]|^Special| NUMANode"
  Package L#0 (P#0 total=15725516KB CPUVendor=AuthenticAMD CPUFamilyNumber=23 CPUModelNumber=96 CPUModel="AMD Ryzen 7 4700U with Radeon Graphics         " CPUStepping=1)
    L3Cache L#0 (P#0 size=4096KB linesize=64 ways=16 Inclusive=0)
      L2Cache L#0 (P#0 size=512KB linesize=64 ways=8 Inclusive=1)
        L1dCache L#0 (P#0 size=32KB linesize=64 ways=8 Inclusive=0)
          Core L#0 (P#0)
            PU L#0 (P#0)
      L2Cache L#1 (P#1 size=512KB linesize=64 ways=8 Inclusive=1)
        L1dCache L#1 (P#1 size=32KB linesize=64 ways=8 Inclusive=0)
          Core L#1 (P#1)
            PU L#1 (P#1)
      L2Cache L#2 (P#2 size=512KB linesize=64 ways=8 Inclusive=1)
        L1dCache L#2 (P#2 size=32KB linesize=64 ways=8 Inclusive=0)
          Core L#2 (P#2)
            PU L#2 (P#2)
      L2Cache L#3 (P#3 size=512KB linesize=64 ways=8 Inclusive=1)
        L1dCache L#3 (P#3 size=32KB linesize=64 ways=8 Inclusive=0)
          Core L#3 (P#3)
            PU L#3 (P#3)
    L3Cache L#1 (P#1 size=4096KB linesize=64 ways=16 Inclusive=0)
      L2Cache L#4 (P#4 size=512KB linesize=64 ways=8 Inclusive=1)
        L1dCache L#4 (P#4 size=32KB linesize=64 ways=8 Inclusive=0)
          Core L#4 (P#4)
            PU L#4 (P#4)
      L2Cache L#5 (P#5 size=512KB linesize=64 ways=8 Inclusive=1)
        L1dCache L#5 (P#5 size=32KB linesize=64 ways=8 Inclusive=0)
          Core L#5 (P#5)
            PU L#5 (P#5)
      L2Cache L#6 (P#6 size=512KB linesize=64 ways=8 Inclusive=1)
        L1dCache L#6 (P#6 size=32KB linesize=64 ways=8 Inclusive=0)
          Core L#6 (P#6)
            PU L#6 (P#6)
      L2Cache L#7 (P#7 size=512KB linesize=64 ways=8 Inclusive=1)
        L1dCache L#7 (P#7 size=32KB linesize=64 ways=8 Inclusive=0)
          Core L#7 (P#7)
            PU L#7 (P#7)

結果を整理すると、次の表のようになります。 この CPU では L2 キャッシュが Inclusive なので、L1 キャッシュに存在するキャッシュラインは L2 キャッシュにも置かれていることが保証されます。

キャッシュ 容量 キャッシュラインサイズ way 数 Inclusive
L1d 32 KiB / core 64 B 8-way 0
L2 512 KiB / core 64 B 8-way 1
L3 4 MiB / 4 cores 64 B 16-way 0

キャッシュレイテンシの計測

L1/L2/L3 キャッシュのロードレイテンシを計測するベンチマークを作成します。 完全なソースコードはこちらです。

バッファ内の要素にランダムアクセスし、ロード 1 回あたりにかかる時間を計測します。 データの供給元によってロードレイテンシがどう変わるかを確認するため、バッファサイズを L1 キャッシュより小さいものから、L3 キャッシュより十分大きいものまで変化させます。 実行時に各キャッシュ階層のキャッシュミス率を計測し、L1/L2/L3 キャッシュのレイテンシを推定します。

バッファサイズごとに 5 種類の乱数シードでベンチマークを実行し、得られたレイテンシの中央値を、そのバッファサイズのロードレイテンシとします。 各シードでは、100 万回のロードを 1 回の試行とし、3 回のウォームアップ実行後に 10 回計測して、サイクル数が最小となった試行の結果を記録します。

ハードウェアプリフェッチ対策

バッファ内の要素に対して規則的にアクセスすると、CPU はアクセスパターンから将来アクセスされる可能性の高い要素を予測し、先行してキャッシュに読み込もうとします。 この機能が有効に働くと、ロードレイテンシを正確に推定するのが難しくなってしまいます。 そこで、アクセスパターンが予測しにくくなるように工夫します。

バッファ内の要素をランダムな順序でつないだ連結リスト(pointer chain)を作り、ポインタを順に辿って要素にアクセスします。 次にアクセスする要素のアドレスは直前のロードが完了するまで確定しないため、アクセス先を事前に予測することが難しくなります。

pointer chain

pointer chain

また、各要素が 1 つのキャッシュラインを占有するようにパディングし、1 回のロードで複数の要素がキャッシュに読み込まれてしまうことを防ぎます。

TLB ミス対策

バッファサイズを大きくすると、アクセスするページ数が増え、TLB ミスの影響が大きくなります。 そこで、2 MiB の huge page を使用してバッファを確保することで、TLB ミスを抑制します。

1
2
3
4
5
6
7
8
void* buffer = mmap(
    nullptr,
    size,
    PROT_READ | PROT_WRITE,
    MAP_PRIVATE | MAP_ANONYMOUS | MAP_HUGETLB,
    -1,
    0
);

これを使うためには、あらかじめ huge page を用意しておく必要があります。 512 個の huge page を確保する場合、ベンチマーク実行前に次のコマンドを実行します。

1
$ echo 512 | sudo tee /proc/sys/vm/nr_hugepages

キャッシュミス率の計測

perf-counter を使ってキャッシュミス数を計測します。 AMD Ryzen 7 4700U (Zen 2) には、L1 データキャッシュへのデータ供給回数を供給元ごとに数えるイベント DATA_CACHE_REFILLS_FROM_SYSTEM が用意されています。

1
2
3
4
5
6
amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM # Demand Data Cache fills by data source
  amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM:MABRESP_LCL_L2 # Fill from local L2.
  amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM:LS_MABRESP_LCL_CACHE # Fill from another cache (home node local).
  amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM:LS_MABRESP_LCL_DRAM # Fill from DRAM (home node local).
  amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM:LS_MABRESP_RMT_CACHE # Fill from another cache (home node remote).
  amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM:LS_MABRESP_RMT_DRAM # Fill from DRAM (home node remote).

MABRESP_LCL_L2 は同一コアの L2 キャッシュからの供給、LS_MABRESP_LCL_CACHE と LS_MABRESP_RMT_CACHE はそれ以外のキャッシュからの供給、LS_MABRESP_LCL_DRAM と LS_MABRESP_RMT_DRAM は DRAM からの供給を表します。 これらを組み合わせて、L1/L2/L3 キャッシュミス数を計測するイベントを次のように定義します。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
constexpr auto L1D_MISS =
    "amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM"
    ":MABRESP_LCL_L2"
    ":LS_MABRESP_LCL_CACHE"
    ":LS_MABRESP_LCL_DRAM"
    ":LS_MABRESP_RMT_CACHE"
    ":LS_MABRESP_RMT_DRAM";
constexpr auto L2_MISS =
    "amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM"
    ":LS_MABRESP_LCL_CACHE"
    ":LS_MABRESP_LCL_DRAM"
    ":LS_MABRESP_RMT_CACHE"
    ":LS_MABRESP_RMT_DRAM";
constexpr auto L3_MISS =
    "amd64_fam17h_zen2::DATA_CACHE_REFILLS_FROM_SYSTEM"
    ":LS_MABRESP_LCL_DRAM"
    ":LS_MABRESP_RMT_DRAM";

L1 データキャッシュミス数は、L1 データキャッシュにデータが供給された回数です。 L2 キャッシュミス数は、そのうち、同一コアの L2 キャッシュから供給されたものを除いた回数です。 L3 キャッシュミス数は、DRAM からデータが供給された回数を表します。 各カウントをロード回数で割り、L1/L2/L3 キャッシュミス率を求めます。

キャッシュレイテンシの推定

計測で得られた L1/L2/L3 キャッシュミス率をそれぞれ m1,m2,m3m_1, m_2, m_3 とすると、データの供給元(L1、L2、L3、DRAM)の割合 h1,h2,h3,hDRAMh_1, h_2, h_3, h_\mathrm{DRAM} は、

h1=1−m1,h2=m1−m2,h3=m2−m3,hDRAM=m3 h_1 = 1 - m_1, \qquad h_2 = m_1 - m_2, \qquad h_3 = m_2 - m_3, \qquad h_\mathrm{DRAM} = m_3

と表せます。

L1、L2、L3、DRAM からデータを取得する際のレイテンシをそれぞれ t1,t2,t3,tDRAMt_1, t_2, t_3, t_\mathrm{DRAM} とすると、実測レイテンシ TT は次式で表せます。

T=h1t1+h2t2+h3t3+hDRAMtDRAM T = h_1 t_1 + h_2 t_2 + h_3 t_3 + h_\mathrm{DRAM} t_\mathrm{DRAM}

この式を基に、計測結果から各キャッシュのレイテンシを推定します。

まず、L1 ミス率が十分に小さい範囲では、すべてのロードが L1 でヒットするとみなし、実測値 TT を L1 レイテンシ t1t_1 とします。

t1=T t_1 = T

次に、L1 ミス率が閾値以上で、L2 ミス率が十分に小さい範囲では、すべてのロードが L1 または L2 でヒットするとみなし、既に求めた t1t_1 を使って t2t_2 を推定します。

t2=T−h1t1h2 t_2 = \frac{T - h_1 t_1}{h_2}

同様に、L2 ミス率が閾値以上で、L3 ミス率が閾値未満の範囲では、ロードが L1、L2、L3 のいずれかでヒットするとみなし、t3t_3 を推定します。

t3=T−h1t1−h2t2h3 t_3 = \frac{T - h_1 t_1 - h_2 t_2}{h_3}

今回は、ミス率の閾値を 0.01% とします。 条件を満たすバッファサイズが複数ある場合は、それぞれから得られた推定値の中央値を、そのキャッシュのレイテンシとして採用します。

ビルドと実行

リポジトリのルートで次のコマンドを実行し、Zen 2 向けにビルドします。 使用した GCC のバージョンは 15.2.1 です。

1
2
$ cmake -S . -B build -DCMAKE_BUILD_TYPE=Release -DMICRO_BENCHMARK_SUITE_ARCH=znver2
$ cmake --build build

CPU コア 7 番を指定し、プロセスの優先度を 99 にしてベンチマークを実行します。

1
$ sudo chrt -f 99 taskset -c 7 ./build/memory_latency/cache_latency

計測結果

AMD Ryzen 7 4700U (Zen 2) での計測結果を次の図に示します2。
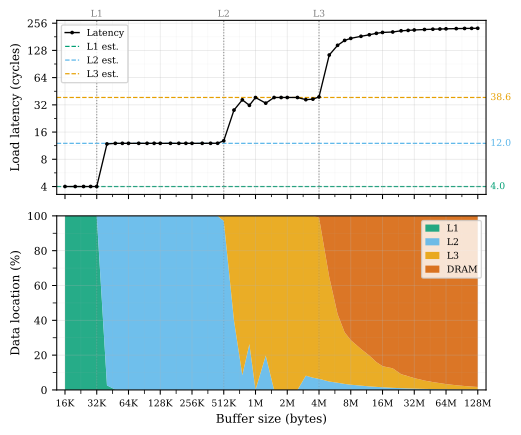
AMD Ryzen 7 4700U の計測結果。上図は、バッファサイズに対する実測レイテンシと L1/L2/L3 キャッシュの推定レイテンシを示す。下図は、ロードが L1/L2/L3 キャッシュでヒットした割合、および DRAM から取得した割合を示す。

AMD Ryzen 7 4700U の計測結果。上図は、バッファサイズに対する実測レイテンシと L1/L2/L3 キャッシュの推定レイテンシを示す。下図は、ロードが L1/L2/L3 キャッシュでヒットした割合、および DRAM から取得した割合を示す。

バッファサイズが L1 キャッシュ容量(32 KiB)以下の場合、L1 キャッシュヒット率はほぼ 100% です。 32 KiB を超えると、L2 キャッシュからデータを取得する割合が上がり、ロードレイテンシが増加します。 バッファサイズをさらに大きくすると、L2、L3 キャッシュについても同様に、各キャッシュの容量を超えた付近で次の階層からデータを取得する割合が上がり、ロードレイテンシが増加します。

バッファサイズが L3 キャッシュの容量よりも十分大きくなると、ほとんどのデータを DRAM から取得するようになり、ロードレイテンシは約 225 サイクルまで増加します。

各キャッシュ階層の推定レイテンシは次の表の通りです。 いずれも AMD のドキュメントに記載されている値とおおむね一致しています。

キャッシュ ロードレイテンシの推定値 AMD のドキュメントに記載されている値
L1d 4.0 サイクル 4〜5 サイクル
L2 12.0 サイクル 12 サイクル以上
L3 38.6 サイクル 平均 39 サイクル

参考


  1. 64 バイトであることが多いです。 ↩︎

  2. 結果のプロットには analyze_cache_latency.py を使用しました。 ↩︎